10 GSPSの超高速AI推論でリアルタイムに粒子のパイルアップを検出
GSI/FAIRでFPGAベースCNNが300 nsのレイテンシでスピル中の全粒子を局在化、120 Gbit/sで処理し、検出器パルスが重なった場合にも対応
www.spdevices.com
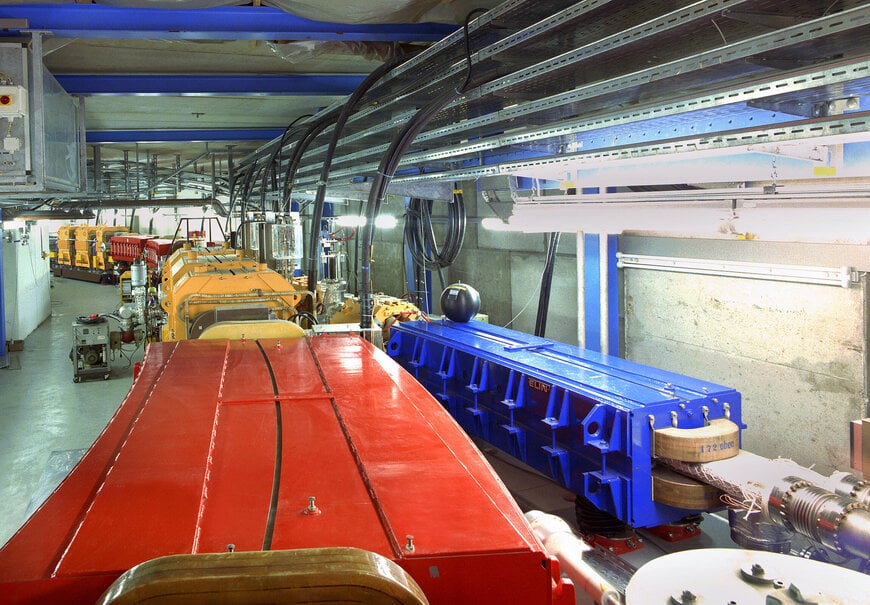
Teledyne ADQ35上で10ギガサンプル/秒(GSPS)で動作するFPGAベースのAI推論により、ドイツ・ダルムシュタットのGSI Helmholtzzentrum für Schwerionenforschungでは、サブマイクロ秒のレイテンシとサブナノ秒の時間分解能を実現し、高い粒子レートで信号が大きく重なり合う場合でも、粒子をリアルタイムかつ高精度に局在化できる。この研究は、Fulda University of Applied SciencesとGSIが共同で実施した博士研究として行われた。FPGAハードウェアに直接実装された畳み込みニューラルネットワーク(CNN)は、わずか300ナノ秒のレイテンシで毎秒120ギガビットのデータを処理する。
スピル中の全粒子をカウント
粒子加速器は、科学実験、材料研究、医療用途向けに、精密に制御された粒子ビームを供給する。GSIでは、SIS18シンクロトロンがリング型加速器内で粒子を加速し、その後、ビームから粒子を取り出して実験設備へ供給する。この取り出されたビームは「スピル」と呼ばれる。スピルを制御するには、スピル中に存在する粒子数と、それらが時間的にどのように分布しているかを把握することが不可欠である。そのためには、加速器の稼働中にスピル内の各粒子をリアルタイムで局在化する必要があり、これは粒子加速器のビーム計測における大きな課題となっている。
ビーム中に検出器を設置すると、通過する各粒子に対してパルスが発生する。これを図1に示す。複数の粒子が短い時間間隔で検出器を通過すると、パルスが重なり合い、検出器の応答が非線形になる場合がある。このようなパルスの重なりは「パイルアップ」と呼ばれ、ビーム強度が高くなるほど発生する可能性が高くなる。パイルアップを適切に分離できない場合、これを回避するためにビーム強度を制限する必要がある。
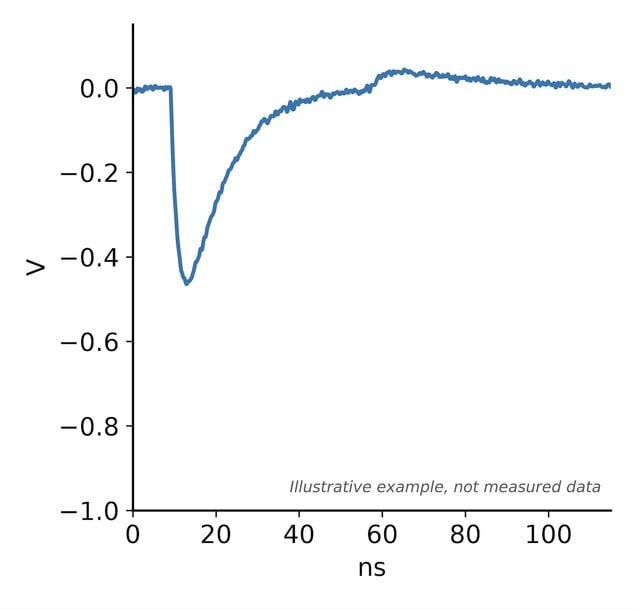
図1. 粒子が検出器に到達した際に発生するパルス。
図2には、このパイルアップが発生した4つの例を示している。各例では、3個の粒子が短い時間間隔で到達した際の信号応答を示している。各粒子の到達時刻は緑色の点線で示されている。
マルチスレッショルド検出や局所最大値探索などの従来手法では、パイルアップが発生すると粒子の検出が困難になり、検出に失敗することも多い。その結果、粒子数を過少にカウントすることになり、スピル制御やその後の実験に悪影響を及ぼす可能性がある。
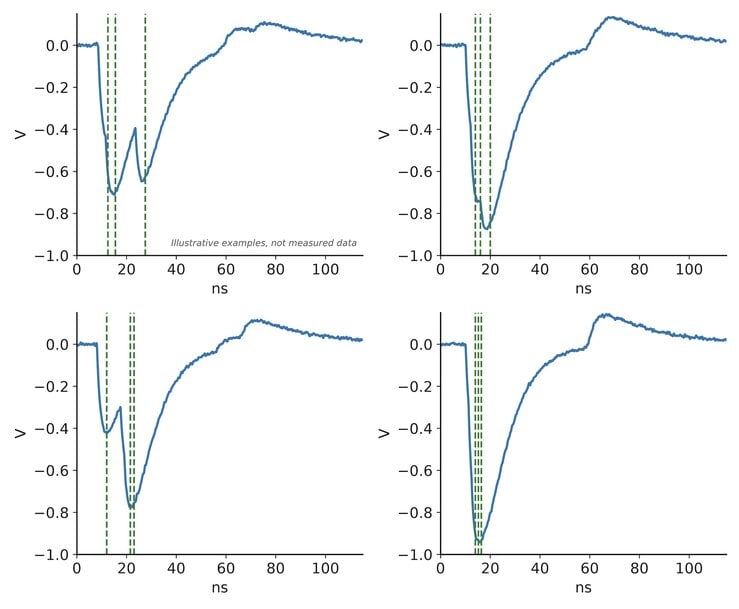
図2. 複数の粒子が短い時間間隔で到達した際の検出器応答。3個の粒子が到達し、それぞれのパルスが重なり合っている。
FPGAによるAIベースの信号処理
この課題に対応するため、ラベル付きデータを用いてCNNを開発・学習した。その後、UFAIRAが開発したツールチェーンを使用し、FPGAハードウェアに直接実装した。
このAIモデルは、パイルアップが発生した場合でも個々のパルスを局在化し、粒子数と到達時刻の情報をリアルタイムで抽出する。これにより、非常に高い粒子レートにおいてもスピルを正確に再構成できる。CNNのFPGA実装はデータをインラインで処理し、決定論的なレイテンシを実現する。これは、スピル制御などのリアルタイムアプリケーションにおいて非常に重要である。
デジタイザへの実装
このソリューションは、最大10 GSPSのサンプリングレートと、オンボードAMD Kintex UltraScale KU115 FPGAを備えたTeledyne SP DevicesのADQ35高速デジタイザを使用して実現されている。これにより、デジタイザ上でリアルタイムAI推論を直接実行するための十分な演算リソースを確保できる。デジタイザ上でデータを直接処理することで、データ転送のボトルネックを回避し、サブマイクロ秒のレイテンシで動作するシステムを実現している。
FPGAに最適化され、ハードウェアを考慮したCNNの学習・実装用ツールチェーンを使用することで、実装されたCNNは312.5 MHzで32サンプルを並列処理し、10 GSPSを実現している。これにより、低く、かつ決定論的なレイテンシと高い精度を両立している。
120 Gbit/sで300 nsのレイテンシ
実装されたCNNは、わずか300ナノ秒のレイテンシを実現し、毎秒120ギガビットのデータを処理する(10 GSPS、1サンプル当たり12ビット)。FPGAで利用可能なDSPリソースの15%未満、LUTリソースの6%未満しか使用しないため、より大規模なモデルを実装したり、さらに高いスループットを目指したりするための十分な余地が残されている。
AIベースのアプローチは、パイルアップ条件下での性能を大幅に向上させ、マルチスレッショルド検出や局所最大値探索などの従来手法を上回る。CNNは、パイルアップが発生したイベントでも個々のパルスを高い信頼性で局在化できるため、粒子レートを下げてパイルアップを回避する必要がなくなる。これにより、検出器ハードウェア自体を変更することなく、はるかに高い粒子レートでシステムを動作させることが可能になる。
高速リアルタイムデータ処理でAIが有効になるのはどのような場合か?
この事例が示すように、複数のイベントが同じ時間帯に発生し、信号が重畳する場合、AIは特に有効となる。また、信号処理が従来手法では複雑すぎる場合や、ドリフト、ノイズ、非線形性などの実環境の影響によって信号形状が変化する場合にもAIは有効である。AIモデルは複雑な信号の挙動を学習し、従来手法ではリアルタイムに復元することが困難、あるいは不可能な情報を抽出できる。
ここで実証されたアプローチは、インラインで低レイテンシの処理を必要とする高速データ分野に幅広く適用できる。例えば、リアルタイムスペクトラム監視や信号分類、RFシステムにおけるチャネル推定、高頻度取引、ネットワーク侵入検知、自律システム向け画像処理など、さまざまな用途が考えられる。
UFAIRAについて
本研究で使用された手法とツールチェーンは現在、UFAIRAの基盤となっている。UFAIRAは、リアルタイム推論向けのカスタマイズされたFPGAベースAIアクセラレータを開発する企業で、Fulda University of Applied Sciencesで行われた博士研究からスピンアウトする形で2026年に設立された。
詳細はこちら: https://ufaira.eu/?utm_source=mepax
Teledyne SP Devicesについて
Teledyne SP Devicesは高速データ収録のパイオニアとして、世界中の要求の厳しいアプリケーション向けに、高度なデジタイザおよび信号処理ソリューションを提供している。10 GSPSデジタイザ技術における初期からのリーダーシップをはじめとする長年のイノベーションの実績を通じて、顧客がより高速、高精度、かつ効率的にデータを収集・処理できるよう支援している。
詳細はこちら: https://www.spdevices.com/en-us?utm_source=mepax